Romuald Texier-MarcadéIngénieur R&D chez Allo-Media / uh!ive
Chez Allo-Media, comme beaucoup d’entreprises, notre chaîne de valeur ressemble à un pipeline : nous collectons les conversations (principalement téléphoniques) que nous envoient nos clients, nous les transcrivons, nous taguons les transcriptions avec des entités nommées, nous anonymisons à la fois la transcription et l’audio, puis nous qualifions le contenu avec des tags sémantiques, et enfin nous indexons le tout et fournissons une UI et une API pour consulter, rechercher et analyser les conversations. Toutes ces étapes sont réalisées automatiquement par des algorithmes de NLP et d’IA.
Ce type de pipeline se prête bien aux architectures orientées services. Pour ajouter une fonctionnalité, on ajoute un nouveau service dans le pipeline.
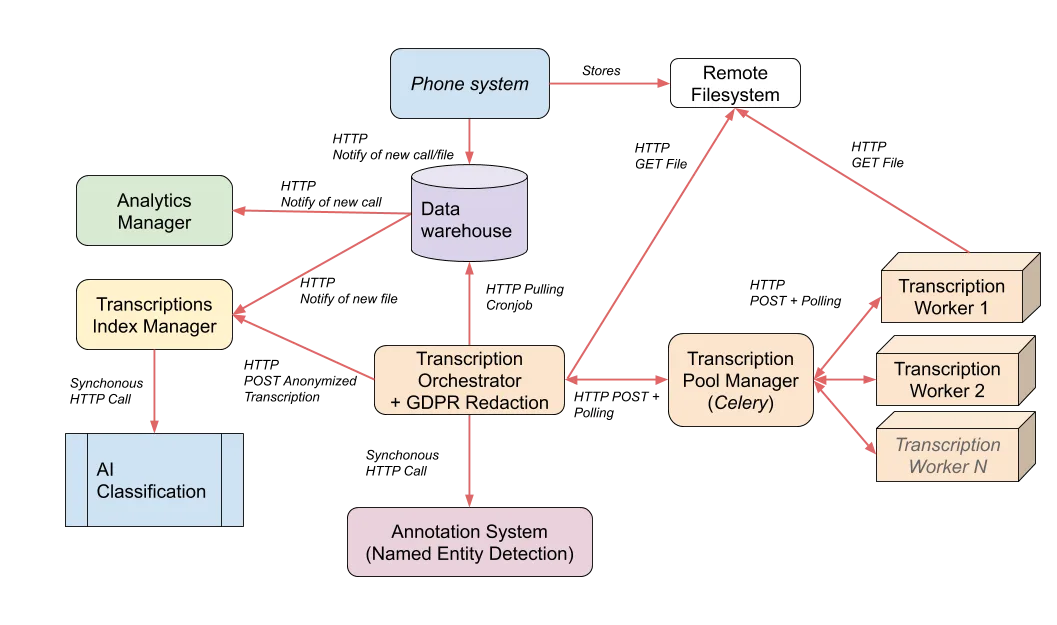
Notre première version reposait sur des services REST.
Malheureusement, comme le montre le schéma ci-dessus, cette approche avait de nombreux inconvénients :
elle introduit un couplage fort entre les composants, puisque presque chaque service doit connaître les services avec lesquels il interagit, leurs adresses, leurs rôles, leurs API… ;
le load balancing demande des solutions ad hoc (comme pour le Transcription Pool Manager avec Celery) ;
la haute disponibilité est délicate à cause de la communication synchrone : si le service appelé est down, l’appelant doit implémenter des stratégies complexes de « retry later » ou abandonner ! Et ainsi de suite pour chaque service.
Mettre à jour ou ajouter des services représente beaucoup de travail, car cela impacte les autres services et demande des mises en production soigneusement coordonnées. Sans compter qu’il faut leur fournir des adresses IP et DNS.
Un an plus tard, avec la croissance de notre activité et l’accélération du développement, nous avons vite compris qu’il nous fallait :
un découplage maximal des services ;
une distribution simple ;
un load balancing sans prise de tête ;
des communications asynchrones one-to-one, one-to-many, many-to-one et many-to-many ;
de la haute disponibilité : redémarrage à chaud des services, ajout ou retrait transparent d’instances de services (workers), résilience à une indisponibilité (raisonnable) de certains services ;
le support de payloads lourds (des mégaoctets d’audio mp3) ;
aucune perte de données, quoi qu’il arrive.
Place à l’architecture pilotée par les événements
La meilleure façon d’atteindre ces objectifs est de sortir de la vision classique du pipeline, et de voir plutôt la chaîne de valeur comme un écosystème de services métier, chacun dédié à une valeur précise, qui réagissent à des événements (entrées) et produisent de nouveaux événements (sorties). Cette nouvelle métaphore n’a pas que des avantages techniques : elle en a aussi sur le plan métier et organisationnel. En raisonnant en unités métier de votre chaîne de valeur, il est plus facile d’identifier les personnes impliquées, les experts métier qui font référence, la valeur exacte apportée par le service, etc.
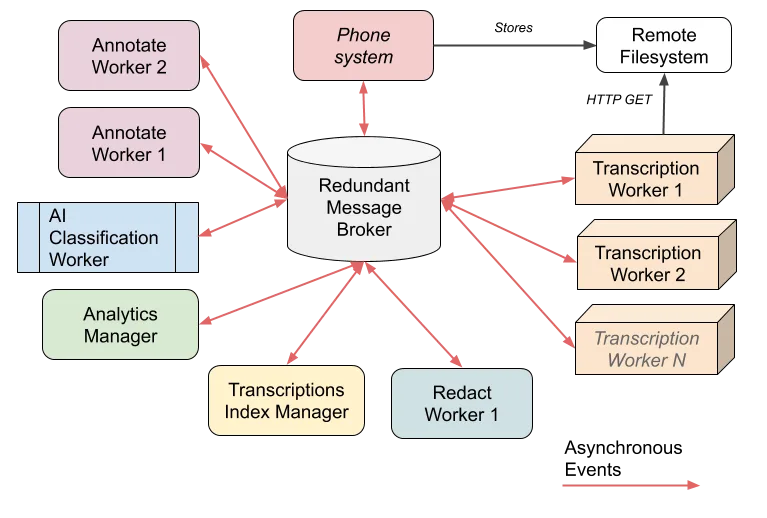
Voici le schéma de notre nouvelle architecture :
Dans cette nouvelle architecture, les événements sont des messages précisément définis qui circulent sur un bus de messages. Chaque service logique (qui implémente un service métier tel que décrit plus haut) s’abonne aux événements qui le concernent, sans avoir besoin de savoir qui les a produits ni comment. Il publie aussi ses propres événements sur le bus, sans se soucier de qui les consomme.
Les services sont ainsi complètement découplés les uns des autres, et le broker qui fait tourner le bus de messages nous apporte gratuitement le load balancing, la distribution et la haute disponibilité.
Désormais, les messages sont l’API, la seule référence métier et technique.
Après beaucoup de réflexion et d’expérimentations, nous avons défini des principes de conception fondamentaux, essentiels à la réussite d’une telle architecture pilotée par les événements. Après 4 mois en production, nous sommes très contents de les avoir respectés dès le départ. Mais ce sera le sujet d’un prochain article. Restez connectés !
Pour faciliter le développement des services EDA, nous avons créé un framework dédié, Eventail, qui masque la topologie et prend en charge tous les comportements attendus des services…